Efeito externo sem registro local — a cobrança passou e o banco não gravou
A captura no adquirente passa e a gravação no seu banco falha: grave a intenção antes de causar o efeito. Escrita dupla, outbox e relay com SQL testado, conciliação, CDC, event sourcing e 2PC.
 Cesar SchutzAtualizado em 10 min de leitura
Neste artigo
Seu serviço cobrou o cliente no adquirente (a empresa que processa a transação de cartão), mas o processo morreu antes de gravar a cobrança no banco. O dinheiro saiu e você não tem registro disso. Este post mostra por que retry e alerta não resolvem, dá nome ao problema (a escrita dupla) e apresenta o desenho que garante que todo efeito externo deixa rastro local: gravar a intenção antes de agir, com tabela outbox, relay e conciliação, com o SQL testado no PostgreSQL. É a continuação de Chave de idempotência.
1. O cenário: a captura passou e o processo morreu
A chave de idempotência está implantada e funcionando. Um dia, o gráfico mostra cobranças que aparecem na fatura do cliente, mas não existem no seu banco.
Investigando, o fluxo é este: o serviço chama o adquirente, a captura (a efetivação da cobrança) passa, e só depois o serviço grava a cobrança no Postgres. Entre as duas coisas, o processo morreu.
Antes de desenhar qualquer coisa, três perguntas mudam a solução: com que frequência isso acontece, se o adquirente permite consultar o status de uma cobrança depois, e quanto tempo o cliente aceita esperar pela resposta. As respostas definem o tamanho da conciliação, se ela é possível e se a captura pode sair do request.
2. Por que retry e alerta não resolvem
A primeira ideia costuma ser envolver a chamada em try/catch: se a gravação falhar, retry algumas vezes; se ainda assim falhar, log e alerta para o time olhar.
Retry e alerta tratam o sintoma depois que o dano já existe. Nenhum dos dois muda o fato estrutural: o efeito externo aconteceu antes de existir qualquer registro local.
E se o processo morre de verdade, não há try/catch que rode: o bloco de tratamento morre junto. Isso acontece quando o contêiner é encerrado à força (SIGKILL), seja por falta de memória (OOM), seja num deploy que estoura o prazo de desligamento. O post SIGTERM e SIGKILL detalha esse ciclo no Kubernetes.
O detalhe mais desconfortável: a chave de idempotência do post anterior não protege aqui. Ela só existiria dentro da linha que não chegou a ser gravada, então o retry seguinte chega sem nada para comparar e captura de novo.
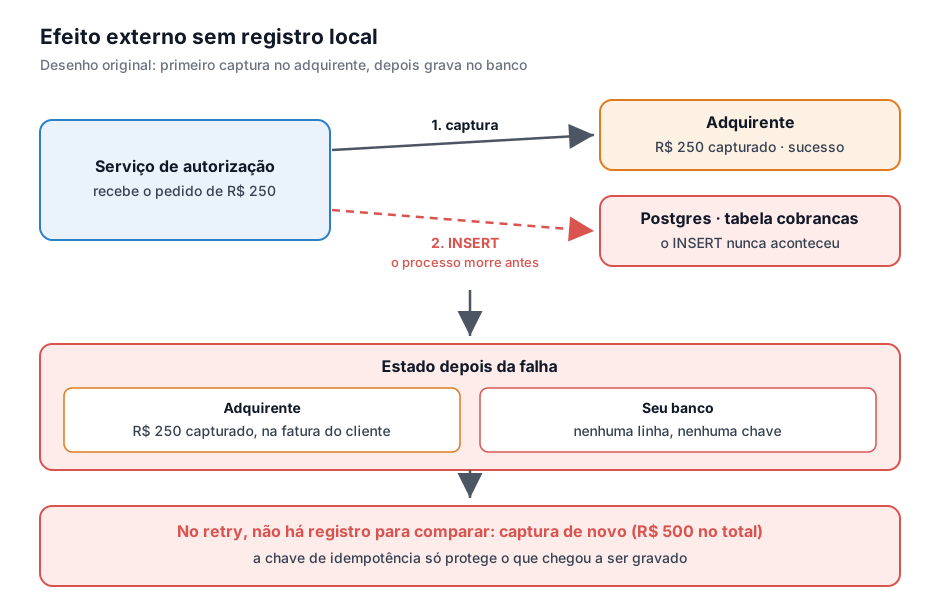
3. O problema tem nome: escrita dupla
Escrever em dois sistemas que não compartilham transação é a escrita dupla (dual write). Seu banco não sabe nada sobre o adquirente, e não existe commit que cubra os dois. Uma falha entre as duas escritas deixa os dois lados discordando. A forma é sempre a mesma, mude o que mudar de nome: banco mais fila, banco mais cache, banco mais índice de busca, banco mais API de terceiro.
O que não resolve, mesmo parecendo que resolve:
- Inverter a ordem: gravar a cobrança como concluída e só depois chamar o adquirente troca o problema de lado. Em vez de cobrança sem registro, você passa a ter registro sem cobrança.
- Retry no catch: só roda se o processo continuar vivo. E, quando a falha é ambígua (um timeout, por exemplo), ela não diz se a operação aconteceu; repetir às cegas pode transformar perda em duplicidade.
- Transação distribuída com 2PC (two-phase commit): um coordenador pergunta a todos os participantes se podem confirmar e só então manda confirmar. Existe e funciona entre recursos que falam o protocolo (o PostgreSQL tem
PREPARE TRANSACTION), mas é bloqueante: os participantes seguram travas enquanto esperam a decisão e, se o coordenador falha, ficam presos. E uma API HTTP de terceiro, como a do adquirente, não é participante de 2PC. É a resposta que parece óbvia para quem acabou de conhecer o problema, e saber por que ela é rejeitada vale mais do que saber que ela existe.
4. Grave a intenção antes de causar o efeito
O que resolve é mudar o que se escreve primeiro: grave a intenção antes de causar o efeito.
- Numa única transação do Postgres, o serviço grava a cobrança com status PENDENTE e, na tabela outbox (uma tabela de eventos a publicar), o evento
CobrancaIniciada. Ou as duas linhas existem, ou nenhuma. - Só depois do commit ele chama o adquirente, enviando a mesma chave de idempotência, se o adquirente aceitar uma (a API da Stripe, por exemplo, aceita o cabeçalho
Idempotency-Key). Assim, repetir a captura é seguro. - Com a resposta, atualiza a linha para CAPTURADO e grava o evento
CobrancaCapturadano outbox, também numa transação só.
Em SQL, com duas tabelas mínimas:
CREATE TABLE cobranca (    id              bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,    idempotency_key text   NOT NULL UNIQUE,    valor_centavos  bigint NOT NULL,    status          text   NOT NULL,   -- PENDENTE, CAPTURADO ou FALHOU    criada_em       timestamptz NOT NULL DEFAULT now(),    atualizada_em   timestamptz NOT NULL DEFAULT now());
CREATE TABLE outbox (    id           bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,    tipo         text  NOT NULL,    payload      jsonb NOT NULL,    criado_em    timestamptz NOT NULL DEFAULT now(),    publicado_em timestamptz             -- NULL = ainda não publicado);
O passo 1 é uma transação com dois INSERTs:
BEGIN;
INSERT INTO cobranca (idempotency_key, valor_centavos, status)VALUES ('7f3a9c1e-2b4d-4f60-9a71-0c5e8d2b3a44', 25000, 'PENDENTE');
INSERT INTO outbox (tipo, payload)VALUES ('CobrancaIniciada',        '{"idempotency_key": "7f3a9c1e-2b4d-4f60-9a71-0c5e8d2b3a44",          "valor_centavos": 25000}');
COMMIT;
Se o processo cair entre um INSERT e o outro, ou antes do COMMIT, não fica nada: num teste forçando um erro no segundo INSERT, a cobrança do primeiro sumiu junto no rollback. E o passo 3 tem a mesma forma, um UPDATE na cobrança e um INSERT no outbox dentro de BEGIN e COMMIT.
Se o processo cair depois do commit, no meio do caminho, sobra um PENDENTE contando exatamente o que faltou terminar. E o retry do cliente agora esbarra numa linha que existe: em vez de capturar às cegas, o serviço sabe que precisa descobrir o que aconteceu com aquela chave.
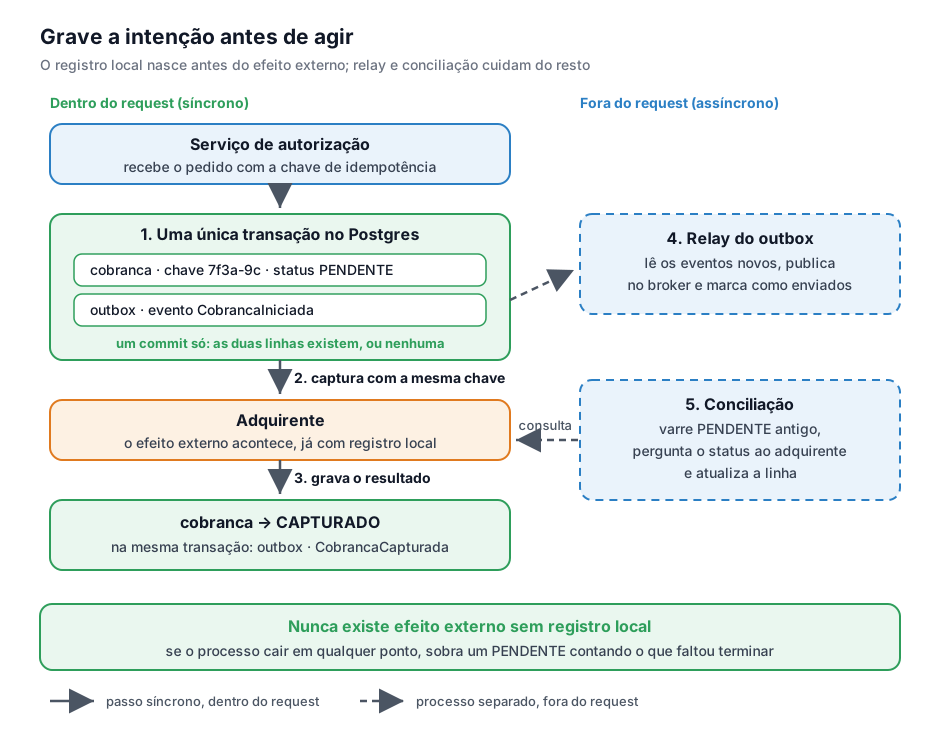
Duas peças completam o desenho, as duas fora do request.
Relay do outbox
Um processo separado lê a tabela outbox, publica os eventos no broker de mensagens e os marca como enviados:
BEGIN;
SELECT id, tipo, payload  FROM outbox WHERE publicado_em IS NULL ORDER BY id LIMIT 100   FOR UPDATE SKIP LOCKED;   -- outro relay em paralelo pega outras linhas
-- publica cada evento no broker
UPDATE outbox   SET publicado_em = now() WHERE id IN (1, 2, 3);       -- os ids do lote publicado
COMMIT;
O SKIP LOCKED permite rodar mais de um relay sem que dois publiquem o mesmo lote: num teste com dois workers ao mesmo tempo, cada um levou três eventos diferentes. Se o relay cair depois de publicar e antes do COMMIT, o lote volta a ficar disponível e é publicado de novo, então a entrega é pelo menos uma vez e quem consome precisa ser idempotente. É o mesmo princípio do post anterior, agora do lado de quem lê. No post sobre W3C Trace Context, o traceparent viaja por esse mesmo outbox.
Conciliação
Um job varre os PENDENTE antigos e pergunta o status ao adquirente:
SELECT id, idempotency_key FROM cobranca WHERE status = 'PENDENTE' AND criada_em < now() - interval '2 minutes' ORDER BY criada_em LIMIT 100 FOR UPDATE SKIP LOCKED;Para cada linha, o job consulta o adquirente pela chave. Se a captura passou, atualiza para CAPTURADO e grava o evento no outbox, na mesma transação; se não passou, marca como falha ou tenta de novo com a mesma chave. Os dois minutos são o prazo que uma cobrança pode ficar sem desfecho antes de alguém perguntar: vêm do tempo normal do request com folga, não de chute. É a rede que pega o que escapou.
O princípio por trás das três peças é o do write-ahead log do banco, em que a mudança é registrada no log antes de ser aplicada, levado para o nível da aplicação. O artigo de Brandur Leach sobre chaves de idempotência formaliza a mesma ideia como fases atômicas com pontos de recuperação. Aparece em upload em duas etapas, emissão de nota fiscal, provisionamento de recurso em nuvem: sempre que a falha precisa deixar rastro em vez de silêncio.
5. Variações: CDC e event sourcing
- Change Data Capture (CDC): em vez de um processo consultar a tabela outbox de tempos em tempos (polling), uma ferramenta lê o log de transações do próprio banco e publica cada mudança quase em tempo real. O Debezium é o nome mais comum. Quando usar no lugar do relay por polling: quando o atraso do intervalo de consulta não cabe, ou quando o volume torna as consultas caras. O que custa: mais uma peça de infraestrutura para operar e monitorar. Por isso o polling, que funciona com qualquer banco SQL, costuma ser o ponto de partida.
- Event sourcing: em vez de guardar o estado atual e emitir eventos, você guarda só a sequência de eventos e calcula o estado a partir dela. Resolve a escrita dupla entre estado e eventos por eliminação: gravar um evento é uma operação só. Atenção: não elimina a chamada ao adquirente; o efeito externo continua precisando da intenção registrada antes. Quando aparece: quando o histórico completo é requisito de negócio, o que é comum em domínio financeiro. O que custa: muda o modelo de dados inteiro e dificulta consultas (em geral exige CQRS), então é decisão de arquitetura, não ajuste pontual. O post Arquitetura de ledger mostra esse modelo, e a conciliação, aplicada a saldos.
6. Decisões que o desenho deixa com você
- Relay parado em silêncio. A métrica certa não é “o relay está rodando”, é o atraso: a idade do evento mais antigo não publicado (
min(criado_em)ondepublicado_em IS NULL), com alerta acima de alguns segundos. Relay vivo com fila crescendo é relay parado. - Quanto tempo um PENDENTE pode ficar. Defina o prazo (minutos, não horas), rode a conciliação em intervalo menor que ele e exponha a contagem de PENDENTE acima do prazo como métrica. Um PENDENTE velho é dinheiro em lugar desconhecido.
- O adquirente responde “não sei”. Não adivinhe. A cobrança fica PENDENTE, a consulta se repete com espera crescente e, passado um prazo de negócio, entra a regra combinada: cancelar com a mesma chave, se a API permitir, ou escalar para tratamento manual. O que não pode é virar CAPTURADO ou FALHOU sem confirmação.
- A tabela outbox cresce sem parar. Evento publicado é lixo depois de alguns dias: um job apaga (ou move para arquivo) as linhas com
publicado_emmais antigo que N dias; em volume alto, particione por dia e solte a partição inteira. - Conciliação como CronJob. Se ela roda como CronJob no Kubernetes,
concurrencyPolicy: Forbidevita duas execuções sobrepostas, e oSKIP LOCKEDda consulta acima faz com que, mesmo que se sobreponham, cada uma pegue linhas diferentes. - Polling ou CDC. Comece pelo polling: funciona com qualquer banco SQL e sem peça nova. Troque por CDC quando o atraso do intervalo não couber no requisito ou quando as consultas ao outbox pesarem.
Fontes
- AWS Prescriptive Guidance — Transactional outbox pattern
- Confluent — Understanding the Dual-Write Problem
- microservices.io — Pattern: Transactional outbox
- microservices.io — Pattern: Polling publisher
- microservices.io — Pattern: Event sourcing
- Debezium — Reliable Microservices Data Exchange With the Outbox Pattern
- Brandur Leach — Implementing Stripe-like Idempotency Keys in Postgres
- Stripe — Idempotent requests
- PostgreSQL — SELECT: cláusula de trava (
FOR UPDATE SKIP LOCKED) - PostgreSQL — Write-Ahead Logging (WAL)
- PostgreSQL — PREPARE TRANSACTION
- Wikipedia — Two-phase commit protocol
- Kubernetes — Assign Memory Resources to Containers
- Kubernetes — Pod Lifecycle: Termination of Pods
tagpagamentos tagmensageria tagbancodedados