Virtual threads no Java 21 — pinning e CLOSE_WAIT
Por que um serviço Java 21 com virtual threads congela sem erro no log: pinning por synchronized (resolvido no Java 24, JEP 491) e CLOSE_WAIT como rastro. Thread dump, JFR, bulkhead e circuit breaker.
 Cesar SchutzAtualizado em 24 min de leitura
Neste artigo
Um serviço Java 21 com virtual threads para de responder no pico, sem nenhum erro no log, e o host acumula milhares de sockets em CLOSE_WAIT. Este post percorre a cadeia inteira desse incidente: por que o processo congela (o pinning de virtual threads dentro de blocos synchronized), por que o CLOSE_WAIT é o rastro e não a causa, como diagnosticar com thread dump e JFR, e o que continua valendo depois da correção: limites explícitos com bulkhead e circuit breaker, com código Java que você pode rodar.
Em quais versões isso acontece. O pinning por
synchronizedexiste do Java 21 ao 23. O Java 24 corrigiu o problema com a JEP 491, e o Java 25 é a primeira LTS com a correção. As seções 5 e 6 (gargalo, bulkhead e circuit breaker) valem para qualquer versão. O modelo de virtual threads está no post do Java 21 e a correção, no post do Java 25.
1. O sintoma: vivo, mudo e cheio de CLOSE_WAIT
Serviço de autorização de cartões, Spring Boot 3 com Tomcat embarcado, Java 21. O time ligou virtual threads para processar as requisições (spring.threads.virtual.enabled=true, disponível a partir do Spring Boot 3.2). Cada autorização chama o adquirente, a empresa que processa a transação de cartão para o lojista.
Dois dias depois, no pico da tarde, uma instância para de responder. Não devolve erro: simplesmente não responde. O health check estoura o tempo, o Kubernetes reinicia o pod, e tudo volta ao normal por algumas horas.
Os sinais:
- A JVM está viva. Sem OutOfMemoryError, sem exceção, sem stack trace no log.
- CPU baixa, memória estável, GC comportado.
- No host, milhares de sockets em CLOSE_WAIT.
- Não reproduz em homologação. O teste de carga sintético passa limpo.
A leitura imediata costuma ser uma destas duas: “acabaram as threads” ou “tem um vazamento de conexão, alguém não está fechando socket”. As duas apontam para o lugar errado, e para ver por que é preciso ter quatro conceitos no lugar.
2. Quatro conceitos antes do diagnóstico
Socket — a ponta que cada lado segura numa conexão de rede. Funciona como o telefone numa ligação: enquanto a ligação existe, ele está ocupado. Cada requisição HTTP em curso usa um, e socket é recurso finito: cada um conta no limite de arquivos abertos do processo.
CLOSE_WAIT — estado TCP que significa “o outro lado desligou, o seu ainda não”. Encerrar uma conexão exige que os dois lados desliguem, e quem desliga do seu lado é a aplicação, chamando close(), não o sistema operacional (RFC 9293). Milhares de sockets nesse estado significam que o código parou de chegar à linha que fecha a conexão.
Platform thread — a thread tradicional do Java, que corresponde a uma thread do sistema operacional (SO). É cara: só a pilha reserva 1 MB por padrão no Linux x64 (documentação do java). Por isso ninguém cria uma por requisição: cria-se um pool, e as requisições se revezam. O Tomcat do Spring Boot usa, por padrão, até 200 (server.tomcat.threads.max). O desperdício aparece quando o trabalho é esperar: 300 ms esperando o adquirente são 300 ms de uma thread ocupada sem fazer nada.
Virtual thread — thread gerenciada pela JVM, não pelo SO. É barata a ponto de uma JVM poder ter milhões (JEP 444). Ela não substitui as threads reais: para executar, é montada sobre uma das poucas carrier threads, que são platform threads de um pool da JVM (por padrão, uma por processador disponível). Quando a virtual thread bloqueia em I/O, a JVM normalmente a desmonta da carrier e coloca outra no lugar. É esse revezamento que faz o modelo funcionar.
3. O diagnóstico: faltou carrier, não faltou thread
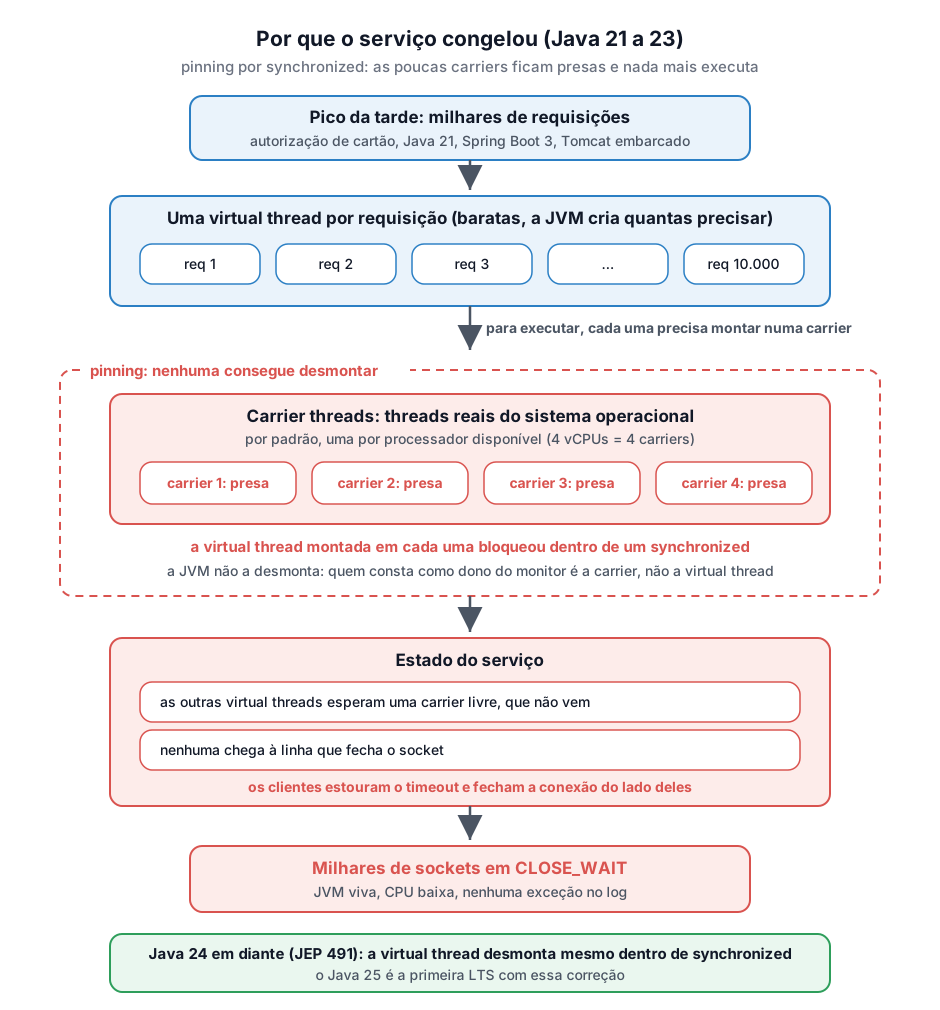
Não faltou virtual thread, faltou carrier. Virtual thread é barata, e a JVM cria quantas forem precisas. O gargalo é o punhado de threads reais embaixo delas. Se cada carrier fica presa a uma virtual thread que bloqueou e não desmontou, pode haver dezenas de milhares de virtual threads prontas, e nenhuma consegue executar. Esse estado tem nome: pinning (a virtual thread fica “pregada” à carrier).
A causalidade é a inversa. O CLOSE_WAIT não é a causa, é a impressão digital. As carriers travaram, então o código parou de rodar, então ninguém chegou à linha que fecha o socket. Os clientes estouraram o timeout e desligaram do lado deles. Milhares de CLOSE_WAIT são o retrato de uma aplicação congelada, não de um bug no fechamento de conexões.
CLOSE_WAIT em massa tem outras causas conhecidas, e vale ter a lista na cabeça: close() que não roda por causa de uma exceção, cliente HTTP sem try-with-resources, pool que nunca devolve a conexão. Todas têm algo em comum com esta: o código parou de chegar à linha que fecha. A diferença é que aqui ele parou de chegar a qualquer linha. É um dos primeiros lugares a olhar quando o processo está vivo, mas mudo.
O diagrama mostra a cadeia completa, do pico de requisições até os sockets em CLOSE_WAIT:
4. Pinning (Java 21 a 23)
No Java 21, a virtual thread fica presa à carrier em dois casos (JEP 444): quando bloqueia dentro de um bloco ou método synchronized, e durante um método nativo ou função estrangeira. O primeiro é o que pesa: segundo a JEP 491, resolvê-lo elimina quase todos os casos de pinning.
O motivo é interno da JVM. Até o Java 23, ela registra como dona do monitor de um objeto (o lock que o synchronized adquire) a platform thread, ou seja, a carrier, e não a virtual thread. Se a virtual thread desmontasse ali dentro, outra virtual thread montada na mesma carrier pareceria dona do monitor, e a exclusão mútua se perderia (JEP 491). Então a JVM não desmonta: a carrier fica bloqueada junto. E a JEP 444 é explícita: o escalonador não compensa o pinning criando carriers extras.
Veja acontecer. O programa abaixo roda 100 tarefas que esperam 100 ms cada, uma vez segurando um synchronized e outra segurando um ReentrantLock. Cada tarefa tem o próprio lock, então ninguém disputa nada: a única diferença é o tipo de lock.
import java.time.Duration;import java.time.Instant;import java.util.concurrent.ExecutorService;import java.util.concurrent.Executors;import java.util.concurrent.locks.ReentrantLock;import java.util.stream.IntStream;
public class CarrierPresa {
    static void esperarAdquirente() {        try {            Thread.sleep(100); // espera de I/O: aqui a virtual thread deveria desmontar        } catch (InterruptedException e) {            Thread.currentThread().interrupt();        }    }
    static void comSynchronized() {        Object monitor = new Object(); // um por tarefa: ninguém disputa o lock        synchronized (monitor) {            esperarAdquirente();        }    }
    static void comReentrantLock() {        ReentrantLock lock = new ReentrantLock(); // um por tarefa, como acima        lock.lock();        try {            esperarAdquirente();        } finally {            lock.unlock();        }    }
    static long medir(Runnable tarefa) {        Instant inicio = Instant.now();        try (ExecutorService executor = Executors.newVirtualThreadPerTaskExecutor()) {            IntStream.range(0, 100).forEach(i -> executor.submit(tarefa));        }        return Duration.between(inicio, Instant.now()).toMillis();    }
    public static void main(String[] args) {        System.out.println("Java " + Runtime.version().feature());        System.out.println("synchronized:  " + medir(CarrierPresa::comSynchronized) + " ms");        System.out.println("ReentrantLock: " + medir(CarrierPresa::comReentrantLock) + " ms");    }}
Rodando com 4 carriers, como numa máquina de 4 vCPUs, nas imagens eclipse-temurin:21 e eclipse-temurin:25:
$ java -Djdk.virtualThreadScheduler.parallelism=4 CarrierPresa.javaJava 21synchronized:  2581 msReentrantLock: 106 ms
$ java -Djdk.virtualThreadScheduler.parallelism=4 CarrierPresa.javaJava 25synchronized:  149 msReentrantLock: 104 ms
No Java 21, com synchronized, só 4 tarefas avançam por vez: 100 tarefas ÷ 4 carriers × 100 ms ≈ 2,5 s. Com ReentrantLock, as 100 esperam juntas. No Java 25, os dois casos se comportam igual. Os tempos exatos variam de máquina para máquina; a proporção é o que importa.
Nem sempre o synchronized está no seu código. A Netflix documentou exatamente esse quadro em julho de 2024: Spring Boot 3, Tomcat embarcado, Java 21, instâncias que paravam de responder e sockets acumulados em CLOSE_WAIT. Ali, o synchronized vinha da biblioteca de tracing Brave (em RealSpan.finish). Dentro dele, as virtual threads esperavam um ReentrantLock do reporter do Zipkin. As instâncias tinham 4 vCPUs, portanto 4 carriers. Com as quatro presas, quando o lock era liberado, a virtual thread que deveria recebê-lo não tinha carrier para executar, e nada mais andava. Os sockets em CLOSE_WAIT batiam com milhares de virtual threads que o Tomcat tinha criado e que nunca chegaram a executar.
É também por isso que homologação passa limpo: pinning só vira travamento quando há concorrência suficiente para prender todas as carriers ao mesmo tempo. Com carga baixa, uma carrier presa passa despercebida.
Como se descobre
-
Thread dump no formato novo. O dump tradicional (
jstackoujcmd <pid> Thread.print) não mostra virtual threads (JEP 444); foi o que confundiu a Netflix no começo, porque o dump parecia ocioso. Usejcmd <pid> Thread.dump_to_file -format=text dump.txt(ou-format=json; o nome do arquivo é obrigatório). Nele, as carriers (ForkJoinPool-1-worker-N) aparecem executandoContinuation.run, e as virtual threads montadas nelas aparecem paradas no mesmo ponto, dentro dosynchronized. Esse ponto é a resposta. As demais virtual threads aparecem sem stack: foram criadas e esperam uma carrier. -
JFR (JDK Flight Recorder), o gravador de eventos embutido na JVM. O evento
jdk.VirtualThreadPinnedregistra, com stack trace, cada vez que uma virtual thread fica parada presa à carrier por mais de 20 ms, o limiar padrão. O evento vem habilitado, mas só é gravado se houver uma gravação ativa:java -XX:StartFlightRecording=filename=rec.jfr ...e depoisjfr print --events jdk.VirtualThreadPinned rec.jfr. NoCarrierPresa.java, o Java 21 grava 100 eventos, um por tarefa comsynchronized; o Java 25 grava zero. Manter o evento ligado em produção, com alerta, é uma das recomendações do artigo da InfoQ citado nas fontes. -
-Djdk.tracePinnedThreads=short(oufull), só do Java 21 ao 23. Imprime o stack sempre que uma virtual thread bloqueia presa, e o frame marcado aponta osynchronized:VirtualThread[#25]/runnable@ForkJoinPool-1-worker-2 reason:MONITORCarrierPresa.comSynchronized(CarrierPresa.java:21) <== monitors:1A JEP 491 removeu essa propriedade no Java 24.
Como se resolve
- Subir para o Java 24 ou mais novo, na prática para o Java 25, a primeira LTS com a JEP 491. A partir dela, a virtual thread desmonta ao bloquear dentro de
synchronizedou emObject.wait(). É o conserto definitivo e vale também para osynchronizeddas dependências. Os detalhes estão no post do Java 25. - Trocar
synchronizedporReentrantLock, se o serviço fica no Java 21. É a mesma exclusão mútua, mas a espera não prende a carrier. A JEP 444 recomenda a troca só onde o bloco roda com frequência e protege I/O potencialmente longo; blocos raros ou que só protegem operações em memória podem ficar como estão. No Java 24 em diante, a JEP 491 volta a recomendarsynchronizedonde for prático. - Atualizar a dependência, se o
synchronizedestá numa biblioteca e uma versão nova já trocou o lock. Se não trocou, não há o que refatorar no seu código: resta subir o Java.
Um upgrade de Java leva semanas, e no plantão a mitigação imediata é outra: desligar as virtual threads por configuração (spring.threads.virtual.enabled=false) e voltar ao pool tradicional. Perde escalabilidade, mas para de cair. Curativo e conserto são coisas separadas.
5. O gargalo mudou de lugar
O Java 25 resolve o pinning por synchronized, mas não resolve o que vem junto com as virtual threads. Esta parte vale para qualquer versão.
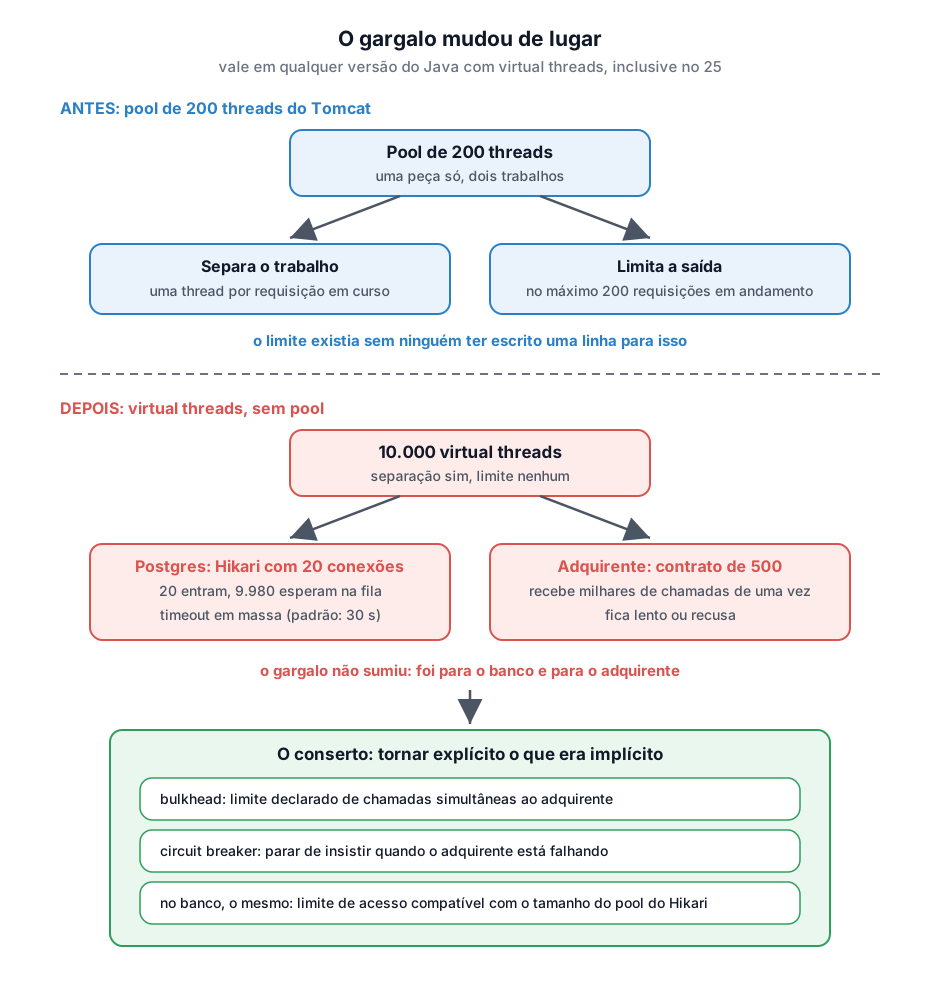
No modelo antigo, o pool de 200 threads do Tomcat fazia dois trabalhos sem ninguém perceber: separava o trabalho de cada requisição e limitava quantas requisições estavam em andamento, portanto quantas chamadas saíam do serviço ao mesmo tempo. Com virtual threads, cada requisição ganha a sua thread, e o segundo trabalho desaparece. A propriedade server.tomcat.threads.max nem tem efeito quando as virtual threads estão ligadas.
Chegam 10 mil requisições no pico:
- No Postgres, nada é derrubado de imediato: forma-se fila. O pool de conexões do HikariCP tem teto (o padrão é 10; digamos que o time configurou 20). Vinte requisições pegam conexão e o resto espera. Quem não consegue conexão em 30 segundos, o
connectionTimeoutpadrão, recebe erro, e isso acontece em massa (HikariCP). Essa fila não existia antes: com 200 threads, no máximo 200 requisições pediam conexão, e as demais nem tinham começado. - No adquirente, é pior, porque o problema sai de casa. Milhares de chamadas simultâneas chegam a um terceiro com contrato para 500. Ele recusa ou fica lento, e aí você tem milhares de conexões abertas esperando.
Virtual threads não eliminam gargalo, mudam o gargalo de lugar. É o mesmo deslocamento de sempre, em outra roupa: aumentar o pool de threads e derrubar o banco, subir réplicas e saturar a rede, paralelizar um job e estourar a cota de uma API de terceiro. Remover um limite não aumenta a capacidade, só empurra a fila para o próximo recurso escasso. O conserto é tornar explícito o que era implícito: um limite declarado em cada recurso compartilhado, com o número decidido por você em vez de herdado do tamanho do pool.
6. As três peças juntas
São três trabalhos diferentes, e nenhum substitui o outro:
- Virtual threads dão vazão, isto é, mais trabalho em andamento ao mesmo tempo. Não deixam nada mais rápido: se o adquirente leva 300 ms, continua levando 300 ms. O que muda é quantas requisições cabem simultaneamente.
- Bulkhead limita a saída. É preventivo e funciona o tempo todo: declara quantas chamadas simultâneas podem sair do serviço para um destino. Devolve o limite que o pool de threads dava de graça.
- Circuit breaker interrompe. É reativo e só age quando o destino está mal: percebe a sequência de falhas e para de insistir por um tempo.
Um sem o outro deixa buraco. Se o adquirente está lento, só com o bulkhead cada requisição ainda espera até 200 ms por uma vaga (o maxWaitDuration dos exemplos abaixo), mais o tempo da própria chamada, para descobrir o que as últimas dezenas de falhas já tinham mostrado.
Vazão — o efeito das virtual threads
Roda direto com java Vazao.java no Java 21 ou mais novo, sem dependência nenhuma. O Thread.sleep faz o papel da chamada ao adquirente.
import java.time.Duration;import java.time.Instant;import java.util.concurrent.ExecutorService;import java.util.concurrent.Executors;import java.util.stream.IntStream;
public class Vazao {
    static void chamadaAoAdquirente() {        try {            Thread.sleep(300); // espera de I/O: a thread não faz nada aqui        } catch (InterruptedException e) {            Thread.currentThread().interrupt();        }    }
    static long medir(ExecutorService executor) {        Instant inicio = Instant.now();        try (executor) { // close() espera todas terminarem            IntStream.range(0, 1000)                     .forEach(i -> executor.submit(Vazao::chamadaAoAdquirente));        }        return Duration.between(inicio, Instant.now()).toMillis();    }
public static void main(String[] args) { System.out.println("pool de 200 threads: " + medir(Executors.newFixedThreadPool(200)) + " ms"); System.out.println("virtual threads: " + medir(Executors.newVirtualThreadPerTaskExecutor()) + " ms"); }}pool de 200 threads: 1623 msvirtual threads: 324 msSão mil chamadas de 300 ms. Com 200 threads, elas saem em cinco levas: no mínimo 1500 ms, um pouco mais na prática, porque criar as threads também custa. Com virtual threads, todas ficam em andamento juntas, perto de 300 ms. É esse número que deveria acender a luz amarela: mil chamadas simultâneas saindo para um terceiro.
Bulkhead — o limite, sem dependência
Também roda sozinho. O Semaphore limita a 100 as chamadas simultâneas, e o programa mostra o pico real de chamadas em andamento e quantas foram recusadas pelo próprio serviço.
import java.util.concurrent.Executors;import java.util.concurrent.ExecutorService;import java.util.concurrent.Semaphore;import java.util.concurrent.TimeUnit;import java.util.concurrent.atomic.AtomicInteger;import java.util.stream.IntStream;
public class BulkheadSimples {
    static final Semaphore limite = new Semaphore(100);    static final AtomicInteger emVoo = new AtomicInteger();    static final AtomicInteger pico = new AtomicInteger();    static final AtomicInteger recusadas = new AtomicInteger();
    static void capturar() {        if (!entrar()) {              // não conseguiu vaga a tempo            recusadas.incrementAndGet();            return;                   // recusa rápida, decidida por você        }        try {            int agora = emVoo.incrementAndGet();            pico.updateAndGet(p -> Math.max(p, agora));            Thread.sleep(300);        } catch (InterruptedException e) {            Thread.currentThread().interrupt();        } finally {            emVoo.decrementAndGet();            limite.release();         // sem isto, o limite vaza até zerar        }    }
    static boolean entrar() {        try {            return limite.tryAcquire(200, TimeUnit.MILLISECONDS);        } catch (InterruptedException e) {            Thread.currentThread().interrupt();            return false;        }    }
public static void main(String[] args) { try (ExecutorService executor = Executors.newVirtualThreadPerTaskExecutor()) { IntStream.range(0, 1000).forEach(i -> executor.submit(BulkheadSimples::capturar)); } System.out.println("pico de chamadas simultâneas: " + pico.get()); System.out.println("recusadas por você: " + recusadas.get()); }}pico de chamadas simultâneas: 100recusadas por você: 900O pico nunca passa de 100, por mais requisições que cheguem. As 100 primeiras entram; as outras 900 esperam 200 ms por uma vaga, e nenhuma vaga abre antes dos 300 ms da chamada, então são recusadas. O finally é o ponto crítico do código: se a permissão não for devolvida em todo caminho de saída, inclusive em exceção, o limite encolhe sozinho até travar tudo.
O nome geral desse freio é backpressure: quem está sobrecarregado sinaliza a quem produz que desacelere, em vez de aceitar tudo e desmoronar. Semáforo, fila limitada e rate limit são formas de aplicar. Virtual threads não aplicam backpressure sozinhas, elas aceitam tudo o que chega; o semáforo é você declarando o freio.
De onde vem o número. Não é chute nem é o contrato do parceiro (o contrato é o teto, não a meta). Vem da lei de Little: chamadas em andamento = vazão × tempo médio de resposta. Cem chamadas por segundo com resposta em 300 ms dão 30 chamadas em andamento, em média. Some uma folga para picos e meça. O 100 dos exemplos é só ilustrativo.
Circuit breaker — com Resilience4j
Aqui entra dependência. No Maven:
<dependency> <groupId>io.github.resilience4j</groupId> <artifactId>resilience4j-circuitbreaker</artifactId> <version>2.4.0</version></dependency>O exemplo abaixo simula um parceiro que falha por um tempo e depois volta, e imprime cada mudança de estado:
import io.github.resilience4j.circuitbreaker.CallNotPermittedException;import io.github.resilience4j.circuitbreaker.CircuitBreaker;import io.github.resilience4j.circuitbreaker.CircuitBreakerConfig;
import java.time.Duration;
public class Breaker {
    static volatile boolean parceiroFora = true;
    static String capturar() {        if (parceiroFora) throw new RuntimeException("adquirente indisponível");        return "CAPTURADO";    }
    public static void main(String[] args) throws Exception {        CircuitBreakerConfig config = CircuitBreakerConfig.custom()            .slidingWindowType(CircuitBreakerConfig.SlidingWindowType.COUNT_BASED)            .slidingWindowSize(20)                        // olha as últimas 20 chamadas            .minimumNumberOfCalls(10)                     // só decide depois de 10            .failureRateThreshold(50)                     // abre com 50% de falha            .waitDurationInOpenState(Duration.ofSeconds(3))            .permittedNumberOfCallsInHalfOpenState(3)     // sondagem ao voltar            .build();
        CircuitBreaker breaker = CircuitBreaker.of("adquirente", config);        breaker.getEventPublisher()               .onStateTransition(e -> System.out.println(">> " + e.getStateTransition()));
        for (int i = 1; i <= 60; i++) {            if (i == 40) parceiroFora = false;  // parceiro se recupera            try {                String resposta = breaker.executeSupplier(Breaker::capturar);                System.out.println(i + ": " + resposta);            } catch (CallNotPermittedException e) {                System.out.println(i + ": barrado pelo breaker, sem sair da aplicação");            } catch (RuntimeException e) {                System.out.println(i + ": falhou no parceiro");            }            Thread.sleep(150);        }    }}
Para rodar sem Maven, basta pôr no classpath os JARs resilience4j-circuitbreaker, resilience4j-core e slf4j-api (java -cp "lib/*" Breaker.java). A saída, resumida (o SLF4J imprime antes um aviso de que não há logger configurado, que pode ser ignorado):
1: falhou no parceiro...9: falhou no parceiro>> State transition from CLOSED to OPEN10: falhou no parceiro11: barrado pelo breaker, sem sair da aplicação...29: barrado pelo breaker, sem sair da aplicação>> State transition from OPEN to HALF_OPEN30: falhou no parceiro31: falhou no parceiro>> State transition from HALF_OPEN to OPEN32: falhou no parceiro33: barrado pelo breaker, sem sair da aplicação...51: barrado pelo breaker, sem sair da aplicação>> State transition from OPEN to HALF_OPEN52: CAPTURADO53: CAPTURADO>> State transition from HALF_OPEN to CLOSED54: CAPTURADO...60: CAPTURADOA sequência inteira aparece:
- As 10 primeiras chamadas falham de verdade. Na décima, a taxa de falha chega a 100% e o breaker abre. A linha
>>sai antes de10: falhouporque o evento dispara quando o breaker registra a falha, antes de a exceção chegar aocatch. - Durante 3 segundos (cerca de 20 voltas de 150 ms), as chamadas são barradas sem sair da aplicação.
- Na primeira chamada depois desse tempo, o breaker passa a meio-aberto e deixa 3 chamadas passarem para sondar. O parceiro ainda está fora, então ele abre de novo.
- O parceiro volta na chamada 40, mas o breaker só descobre na sondagem seguinte, na 52. As 3 chamadas de sondagem dão certo e o breaker fecha.
Os três estados: fechado é o saudável, com a corrente passando (o nome confunde no começo); aberto é o disjuntor desarmado, com falha imediata e sem tráfego; meio-aberto deixa poucas chamadas passarem para sondar e decide se fecha ou abre de novo.
De onde vem, e o que ele não é. O circuit breaker não tem relação com virtual threads. Ele é bem mais antigo: aparece no livro Release It!, de Michael Nygard, de 2007, e ficou conhecido com o Hystrix, que a Netflix abriu em 2012, mais de dez anos antes das virtual threads. O problema que ele resolve é de sistema distribuído: parar de insistir com um serviço que está mal. Vale em qualquer linguagem, com ou sem threads, síncrono ou assíncrono. O mesmo vale para o bulkhead, que vem do mesmo livro; o nome vem das anteparas que dividem o casco de um navio em compartimentos estanques.
A relação com este caso é outra, e vale guardar assim: virtual threads não criaram a necessidade, tiraram o disfarce. O pool de 200 threads dava um limite acidental de graça, e esse limite mascarava a ausência das duas proteções. Ao remover o pool, o que estava escondido apareceu.
Isso importa na hora de aplicar. Quem conclui que “circuit breaker é coisa de virtual thread” deixa de usá-lo nos serviços que continuam com pool, e lá ele é igualmente necessário; só que a falha demora mais a aparecer.
Em produção, com Spring Boot
No Spring Boot, o mesmo vira configuração. O starter do Resilience4j exige o AOP e o Actuator do Spring Boot:
<dependency> <groupId>io.github.resilience4j</groupId> <artifactId>resilience4j-spring-boot3</artifactId> <version>2.4.0</version></dependency><dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-aop</artifactId></dependency><dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-actuator</artifactId></dependency>resilience4j: bulkhead: instances: adquirente: maxConcurrentCalls: 100 maxWaitDuration: 200ms circuitbreaker: instances: adquirente: slidingWindowType: COUNT_BASED slidingWindowSize: 20 minimumNumberOfCalls: 10 failureRateThreshold: 50 waitDurationInOpenState: 3s permittedNumberOfCallsInHalfOpenState: 3@Bulkhead(name = "adquirente")@CircuitBreaker(name = "adquirente", fallbackMethod = "indisponivel")public Resposta capturar(Cobranca cobranca) { return adquirenteClient.capturar(cobranca);}
// mesma assinatura do método protegido, mais a exceção no finalprivate Resposta indisponivel(Cobranca cobranca, Throwable causa) { return Resposta.negada("INDISPONIVEL_TEMPORARIAMENTE");}Com o Actuator, as métricas do bulkhead e do breaker saem pelo Micrometer, e dali para o Prometheus, o Dynatrace ou a ferramenta de observabilidade do time.
Cinco detalhes que costumam morder:
- Use o bulkhead de semáforo, não o de thread pool. O Resilience4j tem as duas variantes, e a de thread pool reintroduz exatamente o pool que você acabou de tirar.
@Bulkheadsemtypejá usa o de semáforo. - As anotações só funcionam através do proxy do Spring. Se outro método da mesma classe chama
capturar()direto, o bulkhead e o breaker não rodam. O motivo está em A pegadinha da self-invocation. - Timeout é pré-requisito. Sem tempo limite na chamada HTTP, ela não falha: fica pendurada. Uma chamada que nunca termina nunca entra na conta do breaker, que então não abre, e as conexões esperando se acumulam.
- O limiar é proporção, não contagem. Baixo demais, o breaker abre por qualquer soluço; alto demais, nunca abre. E o
minimumNumberOfCallsevita que três falhas às três da manhã, com tráfego baixo, abram o disjuntor. - Cuidado com a ordem dos aspectos. Por padrão, o Resilience4j aplica, de fora para dentro: Retry, CircuitBreaker, RateLimiter, TimeLimiter, Bulkhead (a ordem pode ser mudada por propriedades como
resilience4j.retry.retryAspectOrder). Sendo o mais externo, o retry repete o conjunto inteiro. Por isso ele precisa de espera crescente com um pouco de aleatoriedade (backoff exponencial com jitter), ou você cria uma tempestade de retries que derruba de vez quem já estava mal. Em cobrança, retry também exige idempotência: veja Chave de idempotência.
O que devolver para quem foi recusado
Em cartão, negar não é falhar. Um erro genérico obriga a maquininha a decidir sem informação. Uma negativa com um código de indisponibilidade temporária diz que o problema é passageiro, e não uma recusa por saldo ou por suspeita de fraude. Quem recebe pode tentar de novo depois, e quem atende o portador (o titular do cartão) sabe o que aconteceu.
O critério para escolher entre recusa imediata e nova tentativa é o orçamento de tempo. Uma autorização síncrona tem poucos segundos, então recusar rápido é o caminho principal. Retentar fica para os fluxos assíncronos, como ajuste financeiro, estorno e processamento em lote, onde a espera cabe.
7. O que fica depois do conserto
Corrigido o pinning e declarados os limites, sobram decisões que o incidente deixa para o time. São as que eu levaria para a retrospectiva.
- Um upgrade por vez. Java 25 e Spring Boot 4 no mesmo deploy apagam a pista: se algo quebrar, não dá para saber qual dos dois foi. Suba o Java primeiro, que é o que conserta o pinning, estabilize, e só então o framework. O guia de atualizações do Java detalha o processo.
- O que faltava no teste de carga. Ele passou limpo porque não reproduzia o que derruba: concorrência suficiente para prender todas as carriers ao mesmo tempo, o mesmo número de vCPUs da produção (carriers = processadores), as mesmas bibliotecas e agentes (no caso da Netflix, o
synchronizedestava no tracing) e duração para acumular. Teste sem o gargalo da produção só mede o que não importa. - A métrica que avisa que o pinning voltou. O evento
jdk.VirtualThreadPinneddo JFR é a fonte direta: com uma gravação contínua ou com JFR event streaming (jdk.jfr.consumer.RecordingStream, JEP 349) exportando a contagem para o Micrometer, qualquer ocorrência acima do limiar vira alerta. Os sinais indiretos já estavam no incidente: latência subindo com CPU baixa e a contagem de sockets em CLOSE_WAIT no host. Vale manter mesmo no Java 25: ainda há pinning quando código nativo chama de volta código Java que bloqueia (JEP 491), e o Java 26 tirou um dos casos restantes, a espera pela inicialização de uma classe (post do Java 29). ThreadLocaldeixa de ser cache. Virtual threads não devem ser reaproveitadas em pool, então o velho hábito de guardar um objeto caro por thread vira um objeto por requisição, e, como elas podem ser muitas, o consumo de memória só aparece sob carga alta (JEP 444). Para propagar contexto (usuário autenticado, trace id, tenant), o substituto é Scoped Values, finalizado no Java 25 (JEP 506; detalhes no post do Java 25).- O disfarce caiu, o problema era antigo. Bulkhead e circuit breaker existem desde 2007 e servem igual aos serviços que continuam com pool de threads; ali a falha só demora mais para aparecer. Se a conclusão da retrospectiva for “circuit breaker é coisa de virtual thread”, ela saiu errada.
Fontes
- OpenJDK — JEP 444: Virtual Threads (casos de pinning, carriers, thread dump, JFR,
ThreadLocal) - OpenJDK — JEP 491: Synchronize Virtual Threads without Pinning (Java 24)
- OpenJDK — JEP 506: Scoped Values (Java 25)
- OpenJDK — JEP 349: JFR Event Streaming (Java 14)
- Oracle — Virtual Threads (guia do Java 21)
- Oracle — The java Command (tamanho padrão da pilha,
-Xss) - Netflix Technology Blog — Java 21 Virtual Threads: Dude, Where’s My Lock? (julho de 2024)
- InfoQ — Virtual Threads after JDK 24: What Changed for Production Java
- IETF — RFC 9293: Transmission Control Protocol (estados TCP, CLOSE-WAIT)
- Spring Boot — Common Application Properties (
spring.threads.virtual.enabled,server.tomcat.threads.max) - Spring Boot — Spring Boot 3.2 Release Notes (suporte a virtual threads)
- HikariCP — README (
maximumPoolSizeeconnectionTimeoutpadrão) - Resilience4j — CircuitBreaker, Bulkhead e Getting Started com Spring Boot 3 (dependências, ordem dos aspectos, fallback)
- Martin Fowler — CircuitBreaker
- ACM Digital Library — Release It!: Design and Deploy Production-Ready Software (Michael T. Nygard, 2007)
- Netflix Technology Blog — Introducing Hystrix for Resilience Engineering (novembro de 2012)
- Wikipedia — Little’s law
- AWS Architecture Blog — Exponential Backoff And Jitter
tagvirtualthreads tagconcorrencia tagjvm