Parquet e snapshots — o arquivo não garante a fotografia
Como o Parquet organiza dados por colunas, o que torna um snapshot consistente e por que exportar tabelas não substitui um backup do banco.
 Cesar Schutz5 min de leitura
Neste artigo
Você recebe uma pasta com arquivos . e ouve que aquilo é um snapshot do banco. Antes de usar os dados no relatório ou planejar uma restauração, precisa responder duas perguntas: como os arquivos foram gravados e qual estado do banco eles representam?
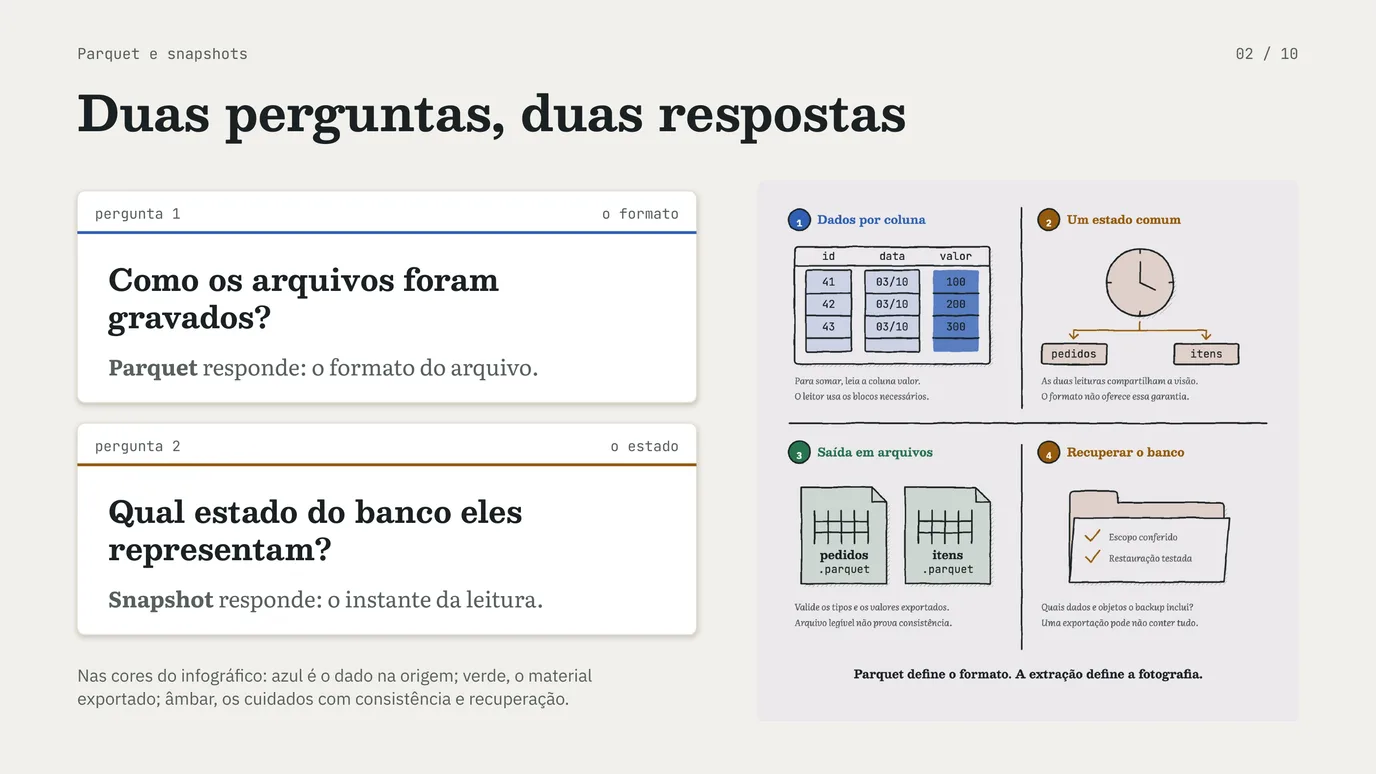
Parquet responde à primeira. Snapshot responde à segunda. O infográfico separa essas responsabilidades em quatro quadros: a organização por colunas, o instante da leitura, os arquivos exportados e a recuperação do banco. Azul identifica o dado na origem; verde, o material exportado; âmbar, os cuidados com consistência e recuperação.
Parquet: o formato do arquivo
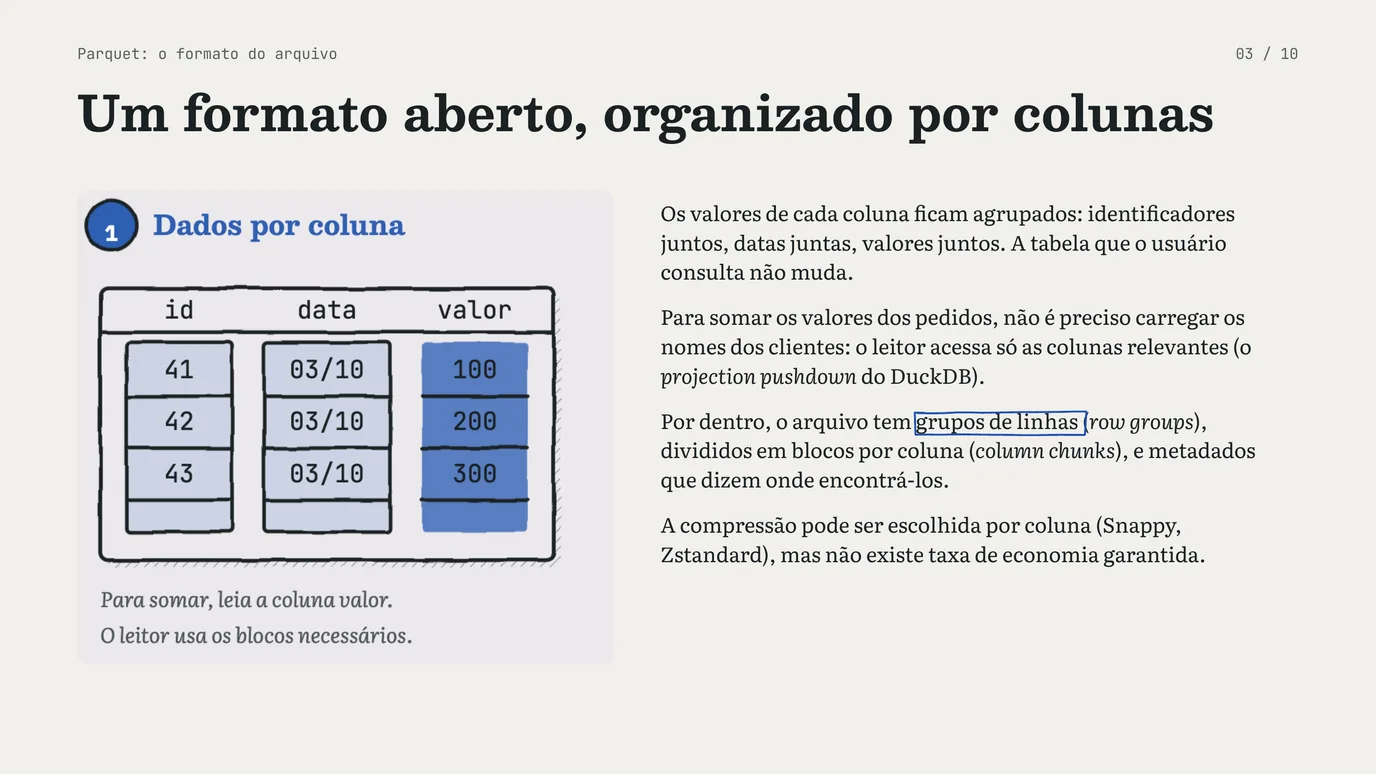
O Apache Parquet é um formato aberto e colunar. No quadro 1, os valores de cada coluna aparecem agrupados: identificadores juntos, datas juntas, valores juntos. É uma representação simplificada da organização física, não uma mudança na tabela que o usuário consulta.
Isso ajuda quando a análise usa poucas colunas. Para somar os valores dos pedidos, não é necessário carregar os nomes dos clientes. Um leitor compatível pode acessar as colunas relevantes; o DuckDB documenta essa otimização como projection pushdown.
Por dentro, o arquivo tem grupos de linhas (row groups), divididos em blocos por coluna (column chunks), além de metadados que indicam onde encontrá-los. Essa estrutura do arquivo permite localizar os blocos necessários. Colunar não significa que toda uma coluna gigantesca fique num único bloco.
A compressão pode ser escolhida por coluna, aproveitando as características dos valores. O formato admite codecs como Snappy e Zstandard. Não existe uma taxa de economia garantida: tamanho e desempenho dependem dos dados, da configuração e do leitor.
Snapshot: o estado capturado
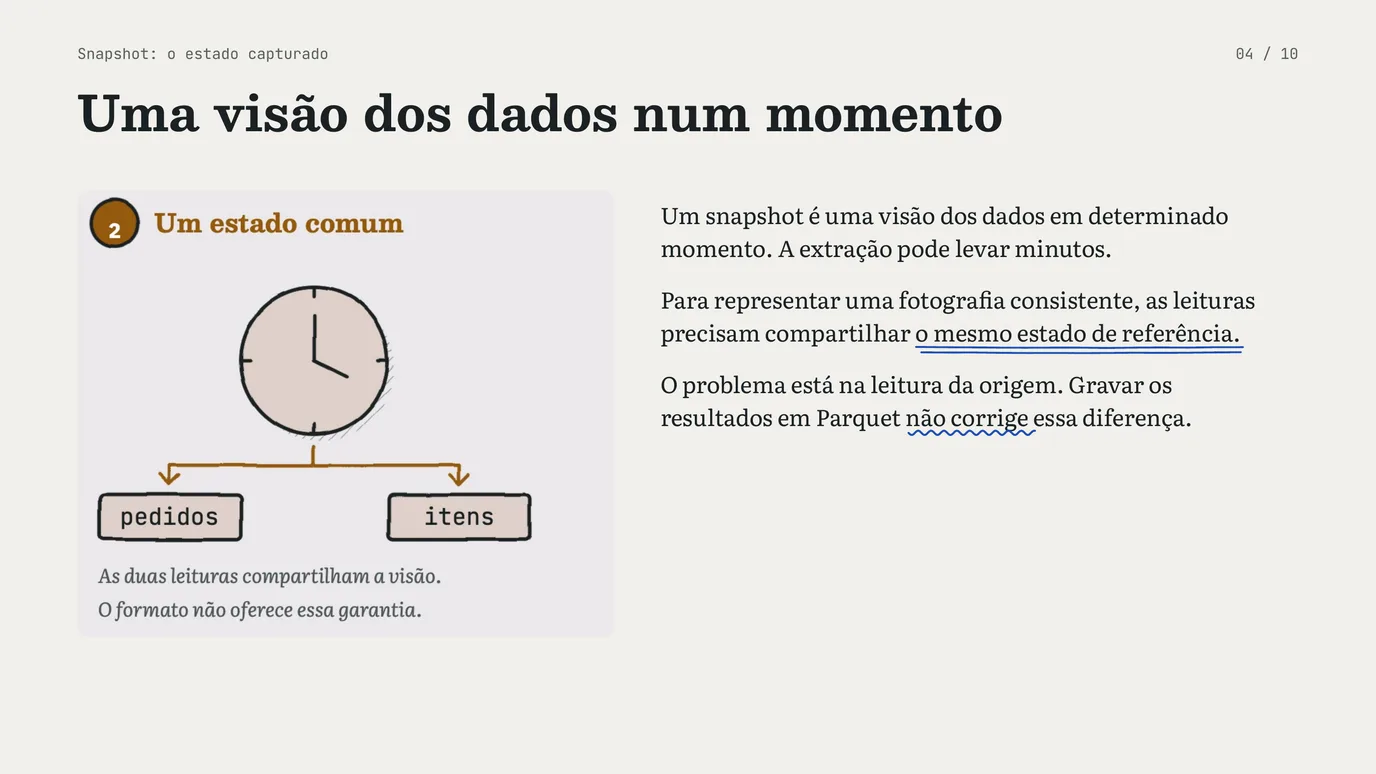
No quadro 2, o relógio representa o ponto de referência da leitura. Um snapshot é uma visão dos dados em determinado momento. A extração pode levar minutos; para representar uma fotografia consistente, suas leituras precisam compartilhar o mesmo estado de referência.
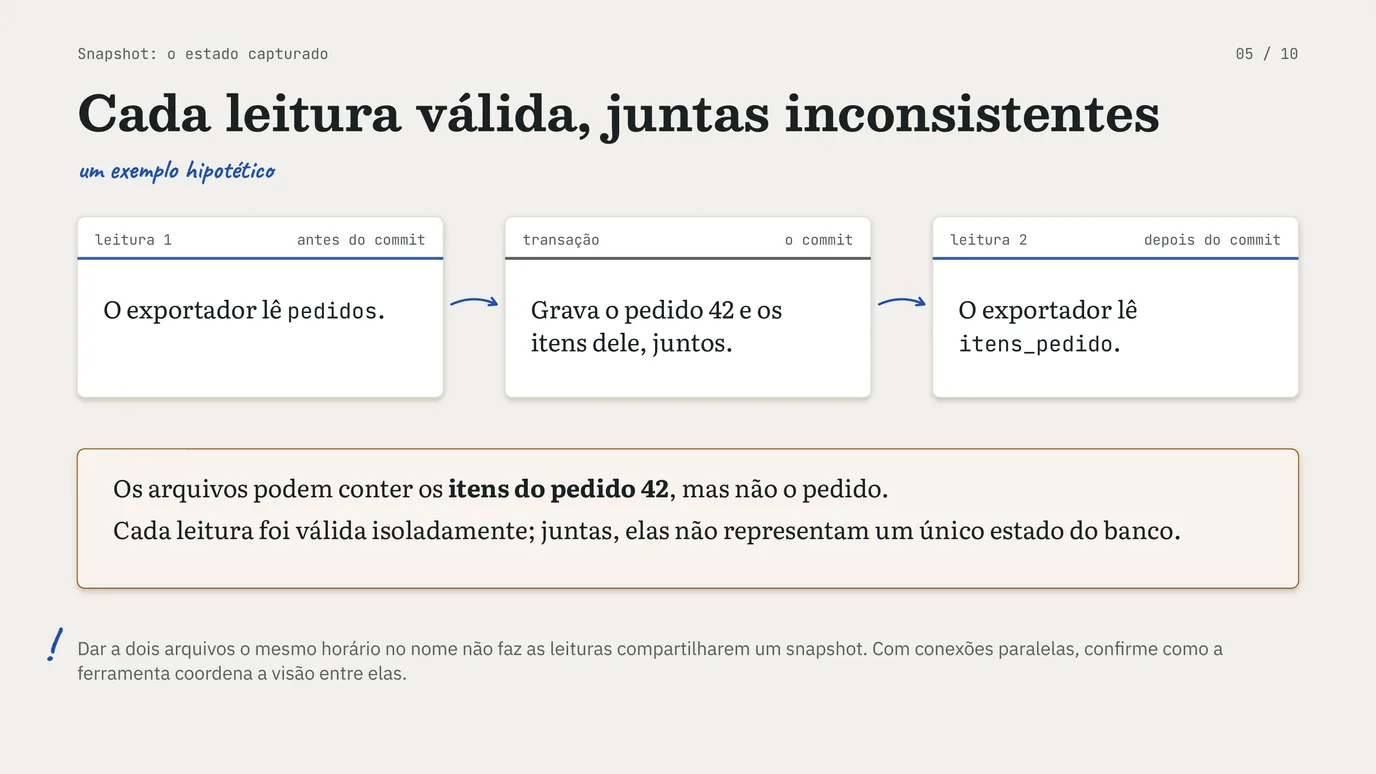
Considere este exemplo hipotético: uma transação grava o pedido 42 e seus itens juntos. O exportador lê pedidos antes desse commit e itens_pedido depois. Os arquivos resultantes podem conter os itens do pedido 42, mas não o pedido. Cada leitura foi válida isoladamente; juntas, elas não representam um único estado do banco.
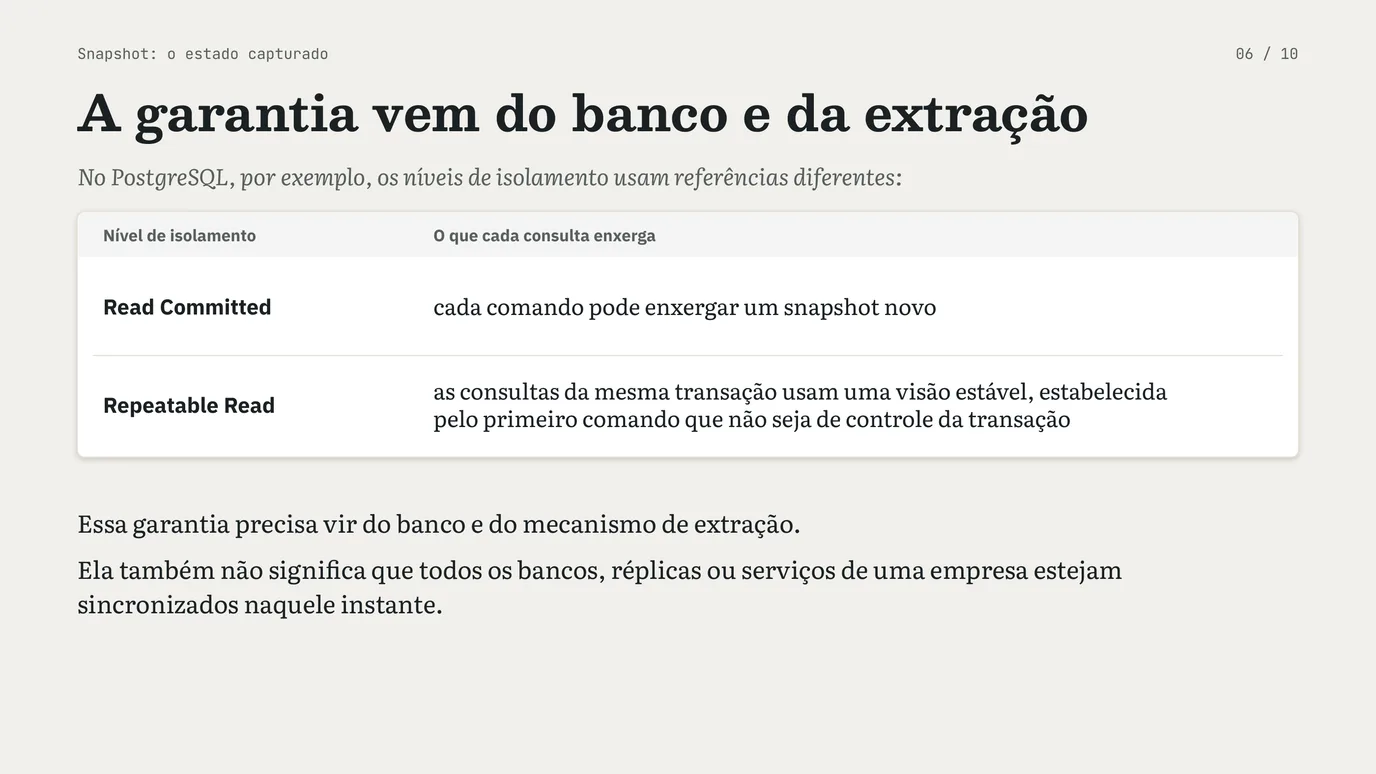
O problema está na leitura da origem. Gravar os resultados em Parquet não corrige essa diferença. No PostgreSQL, por exemplo, Read Committed e Repeatable Read usam referências diferentes: no primeiro, cada comando pode enxergar um snapshot novo; no segundo, as consultas da mesma transação usam uma visão estável, estabelecida pelo primeiro comando que não seja de controle da transação.
Dar a dois arquivos o mesmo horário no nome não faz suas leituras compartilharem um snapshot. Se a extração usa conexões paralelas, confirme como a ferramenta coordena a visão entre elas.
Essa garantia precisa vir do banco e do mecanismo de extração. Ela também não significa que todos os bancos, réplicas ou serviços de uma empresa estejam sincronizados naquele instante.
Onde os arquivos entram
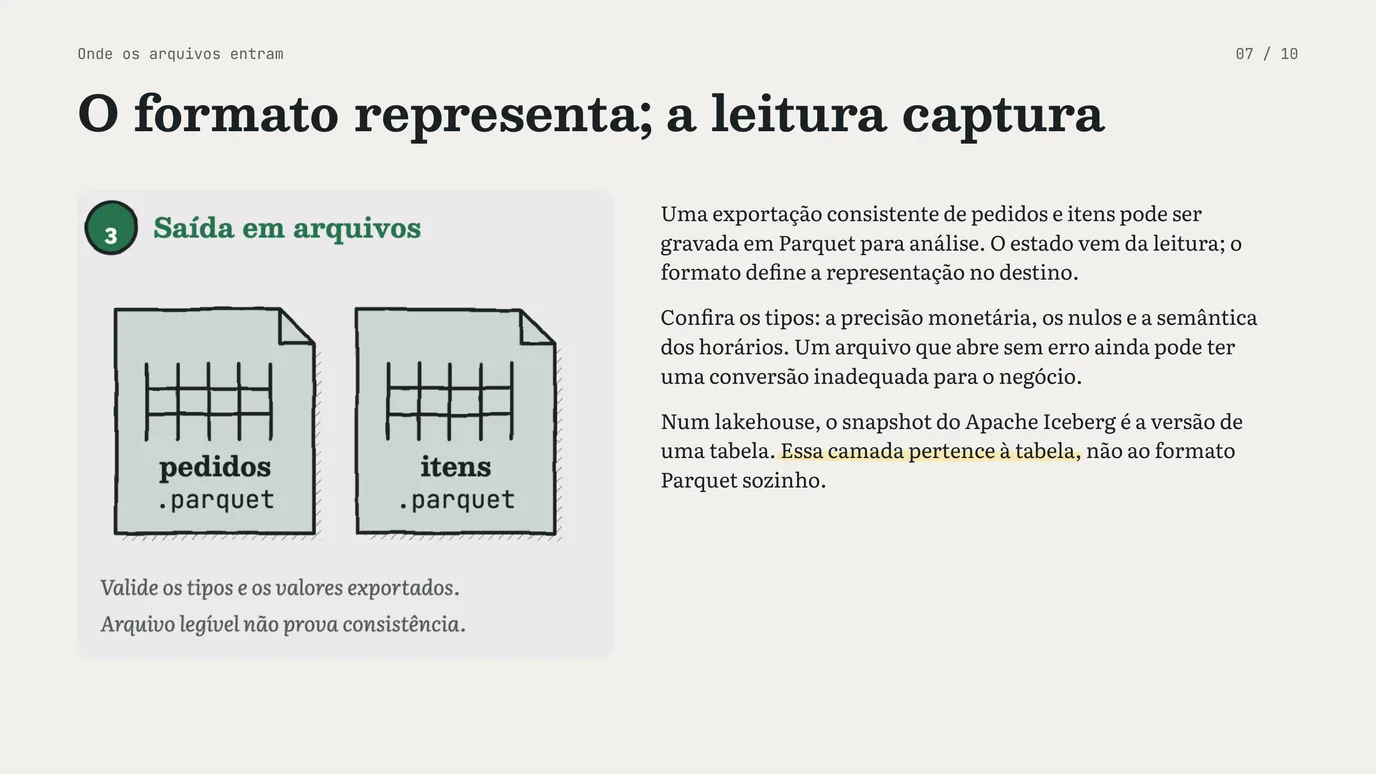
O quadro 3 mostra a saída: arquivos separados por tabela, pertencentes à mesma extração. Uma exportação consistente de pedidos e itens pode ser gravada em Parquet para análise posterior. O estado capturado vem do processo de leitura; o formato define a representação no destino.
Além dos valores, é preciso conferir os tipos. A especificação de tipos lógicos do Parquet descreve como interpretar decimais, datas e timestamps. Ao validar uma exportação, compare a precisão monetária, os valores nulos e a semântica dos horários com a origem. Um arquivo que abre sem erro ainda pode ter uma conversão inadequada para o negócio.
Há também outro uso de “snapshot”: a versão de uma tabela num lakehouse. Na especificação do Apache Iceberg, os snapshots apontam para os metadados que identificam os arquivos daquela versão. Essa camada pertence à tabela, não ao formato Parquet sozinho.
Uma pasta com arquivos Parquet não ganha automaticamente transações e histórico consultável. E um snapshot de uma tabela Iceberg não prova, por si só, que duas tabelas foram extraídas do banco de origem no mesmo instante. Para o contexto arquitetural, veja o post sobre data lake, data warehouse e lakehouse.
Exportação e backup
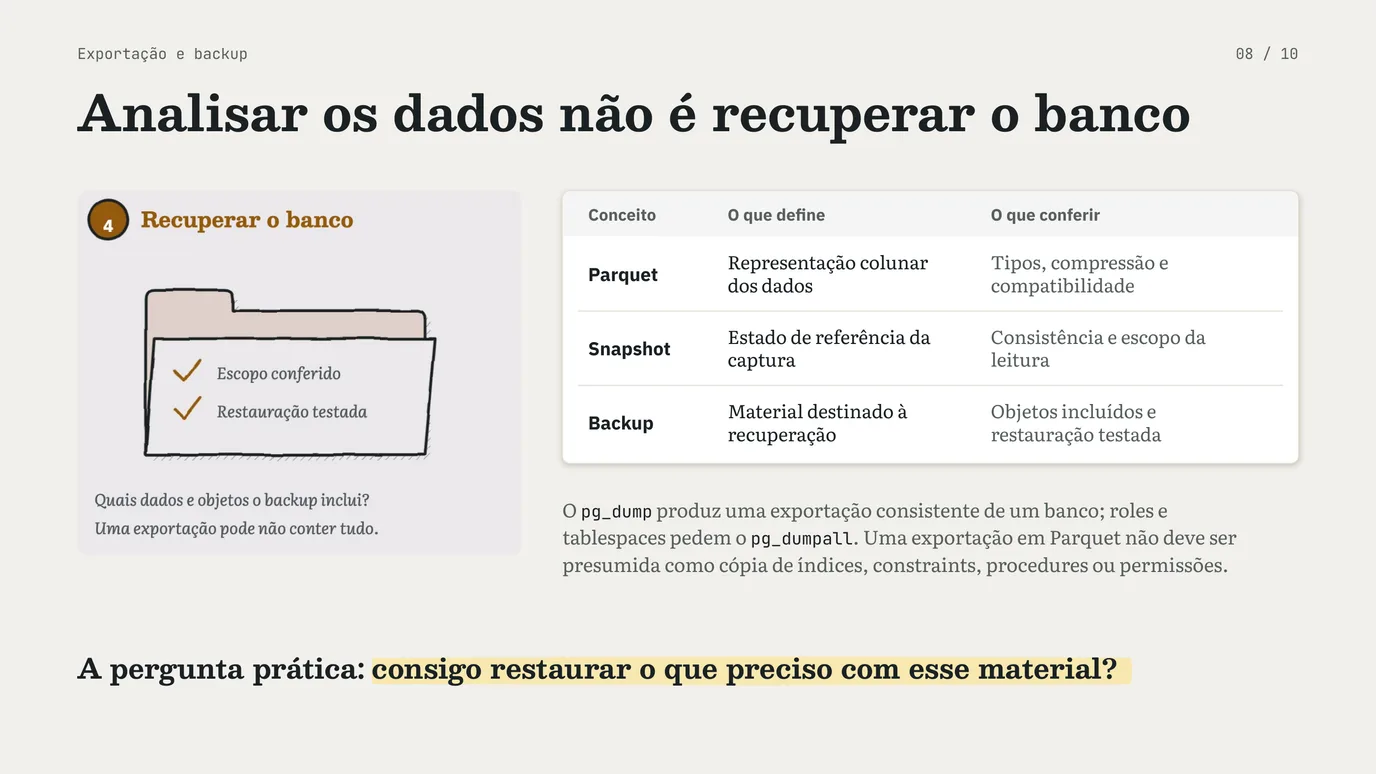
O quadro 4 separa duas finalidades: analisar os dados e recuperar o banco. Exportar tabelas para Parquet pode atender à primeira. Para a segunda, é preciso um mecanismo que preserve o necessário à restauração, dentro do escopo escolhido.
| Conceito | O que define | O que conferir |
|---|---|---|
| Parquet | Representação colunar dos dados | Tipos, compressão e compatibilidade |
| Snapshot | Estado de referência da captura | Consistência e escopo da leitura |
| Backup | Material destinado à recuperação | Objetos incluídos e restauração testada |
A documentação de backup lógico do PostgreSQL ilustra essa diferença: pg_dump produz uma exportação internamente consistente de um banco; objetos globais, como roles e tablespaces, exigem atenção adicional com pg_dumpall. Mesmo backups nativos têm limites de escopo.
Uma exportação de valores em Parquet não deve ser presumida como cópia de índices, constraints, procedures ou permissões. A pergunta prática é: consigo restaurar o que preciso com esse material? A resposta deve vir de um teste de recuperação, não da extensão dos arquivos.
Lembrete: Para análise, confira formato e consistência. Para recuperação, confira o escopo do backup e teste a restauração.
Apresentação
Fontes
- Apache Parquet: visão geral, motivação e estrutura do arquivo.
- Apache Parquet: compressão e tipos lógicos.
- DuckDB: leitura parcial de Parquet.
- PostgreSQL: isolamento de transações e backup lógico.
- Apache Iceberg: especificação dos snapshots.
tagbancodedados tagtradeoffs